A movimentação lateral mais rápida registrada em 2025 levou 27 segundos. O ciclo médio global para identificar e conter uma violação continua medido em centenas de dias. Nenhum reforço de equipe fecha essa distância — e nenhuma ferramenta nova, sozinha, também. Este artigo propõe um caminho diferente: fazer a especificação de software virar política de runtime, tirar a IA generativa do caminho crítico da contenção e caber a resposta em cinco segundos.
A ARITMÉTICA QUE NÃO FECHA
O adversário otimizou o relógio. A defesa otimizou o relatório.
Toda arquitetura de segurança embute, silenciosamente, uma hipótese sobre tempo. A maioria das que estão em produção hoje foi desenhada quando o intervalo entre o acesso inicial e a movimentação lateral era medido em horas.
Esse intervalo — o breakout time — caiu para 29 minutos em média no ecossistema do cibercrime em 2025, com o caso mais rápido já registrado em 27 segundos. Em uma das intrusões analisadas, a exfiltração começou quatro minutos depois do acesso inicial.3 Do outro lado, o tempo médio global para identificar e conter uma violação foi de 241 dias na medição mais recente com número público consolidado, e o relatório de 2026 aponta que os custos de detecção e escalonamento voltaram a subir.12
Colocados na mesma escala, os dois números não descrevem uma diferença de eficiência. Descrevem sistemas que operam em ordens de grandeza distintas.
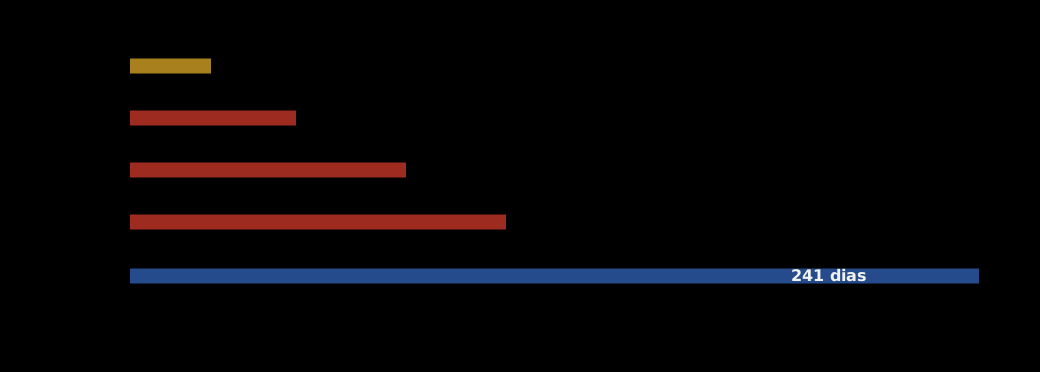
organizações violadas. A distância entre a segunda e a quinta barra é de aproximadamente seis ordens de
grandeza. Fontes: 1, 2, 3.
Há duas leituras possíveis dessa prancha. A leitura confortável é que precisamos detectar mais rápido. A leitura desconfortável — e a que este artigo defende — é que a contenção precisa deixar de depender de detecção humana, porque não existe processo com humano no caminho crítico que caiba em 27 segundos.
Vale registrar o que a própria indústria já observa: organizações que usam IA e automação nas operações de segurança reduziram o custo médio de violação em cerca de US$ 2 milhões, e mesmo assim uma em cada quatro ainda não adotou essas ferramentas.1 No Brasil, o custo médio de uma violação chegou a R$ 7,19 milhões, com saúde, finanças e serviços acima de R$ 8,5 milhões.2 O problema, portanto, não é a ausência de evidência econômica. É que a automação foi instalada onde já havia processo, e não onde há lacuna. O dado mais revelador de 2026 é exatamente esse desalinhamento: mais da metade das organizações já aplica agentes a detecção e contenção, mas apenas 18% aplicam agentes à gestão de vulnerabilidades — justamente o elo onde a janela de exploração encolheu de meses para horas.14
O DIAGNÓSTICO
A defesa não falha no runtime. Ela falha na cobertura da engenharia.
Quando se separa os incidentes de 2025 e 2026 por origem, quase todos apontam para o mesmo lugar: uma decisão de engenharia de software que nunca foi verificada, declarada ou revogada. O retiro europeu sobre o futuro da engenharia de software, realizado em junho de 2026, chegou a uma conclusão que a comunidade de segurança deveria adotar sem alterações: a geração de código deixou de ser o gargalo — a verificação virou o gargalo. Agentes produzem código, especificações, testes e infraestrutura mais rápido do que qualquer organização consegue estabelecer confiança neles.
Traduzindo para risco cibernético: a IA amplifica a disciplina que já existe. Organizações com cultura fraca de teste, propriedade difusa de risco e higiene documental ruim vão piorar mais rápido, não melhorar. Abaixo, as seis lacunas de cobertura onde essa amplificação se converte em exposição de dados — todas com número público.
Lacuna 1 Verificação
Cerca de 44% das tarefas de geração de código introduzem uma vulnerabilidade conhecida quando o pedido não menciona segurança explicitamente. A taxa média de aprovação em segurança está travada em 56% ao longo de mais de 100 modelos avaliados, enquanto a taxa de aprovação sintática beira 100%. Em cross-site scripting, o código gerado passa em apenas 15% das tarefas.5
O agravante é de escala, não de taxa: a IA já responde por cerca de metade do código commitado. A mesma taxa de falha aplicada a um volume muito maior.
Lacuna 2 Identidade não humana
28,65 milhões de segredos novos foram detectados em commits públicos em 2025 — alta de 34% e o maior salto anual já registrado. Repositórios internos são cerca de 6× mais propensos a conter segredos que os públicos, e 28% dos incidentes nascem fora do código, em ferramentas de colaboração. Só em arquivos de configuração de protocolos de contexto para agentes foram encontrados 24.008 segredos únicos no primeiro ano de adoção.6
Lacuna 3 Remediação
Pela primeira vez em 19 anos, a exploração de vulnerabilidade superou o roubo de credenciais como principal porta de entrada: 31% das violações contra 13%. Ao mesmo tempo, apenas 26% das vulnerabilidades sabidamente exploradas foram remediadas em 2025, contra 38% no ano anterior.4 A janela entre divulgação e exploração encolheu de meses para horas; o backlog cresceu.
Lacuna 4 Fronteira e cadeia
Violações envolvendo terceiros chegaram a 48% do total, alta de 60% em um ano.4 Surgiu ainda um vetor novo e específico da era dos agentes: prever quais bibliotecas inexistentes o modelo tende a alucinar e publicar pacotes maliciosos com exatamente esses nomes. Sandbox não resolve — a dependência ainda chega à produção.7
Lacuna 5 Intenção
Esta é a única lacuna sem número público, e não por acaso: não existe métrica porque não existe o artefato. Praticamente nenhuma organização mantém, versionado junto ao código, um registro legível por máquina do que cada serviço tem permissão de fazer — quais identidades, quais destinos, quais classes de dado, quais volumes. A detecção é escrita a partir do comportamento do atacante, nunca do contrato do sistema.
Os sintomas aparecem nos dados vizinhos: apenas 37% das organizações violadas cifram dados sensíveis em repouso e em trânsito, e só 34% têm visibilidade dos próprios ativos criptográficos.1
Lacuna 6 Governança da IA interna
Incidentes com IA não sancionada saltaram de 20% para 43% das organizações violadas em um ciclo. Entre as que sofreram violação relacionada a IA, 92% não tinham controle de acesso adequado. Mais de 20% relataram violação mirando diretamente modelos ou aplicações de IA, com as causas principais em APIs, aplicações e plug-ins comprometidos (27%) e configuração incorreta de nuvem em cargas de IA (27%).1

Repare no formato do problema. Nenhuma dessas seis lacunas é um problema de detecção. Todas são problemas de cobertura de engenharia: algo foi construído, integrado ouConteúdo Interno concedido sem que existisse um artefato verificável descrevendo o que aquilo deveria fazer. O runtime apenas exibe a conta.
A TESE
Detecção deveria ser um subproduto da especificação.
Três inversões sustentam o modelo. Cada uma contraria uma prática consolidada, e cada uma tem base empírica em trabalhos publicados neste ano.
Primeira inversão — a detecção nasce do contrato, não do relatório de ameaça
Hoje, engenharia de detecção parte do comportamento observado do adversário: alguém publica uma técnica, alguém escreve uma regra. É um processo estruturalmente reativo e de cobertura desconhecida, porque não existe denominador — ninguém sabe qual fração do comportamento possível está coberta.
A alternativa é inverter a fonte. Se cada mudança de software carrega um artefato estruturado e versionado que declara quais identidades podem agir, quais destinos podem ser alcançados, quais classes de dado são tocadas, em que volume e com qual reversibilidade, então qualquer coisa fora desse envelope é anômala por construção — não por estatística. O denominador passa a existir.
Esse artefato não precisa ser inventado. O trabalho sobre desenvolvimento dirigido por prompt estruturado já propõe exatamente essa estrutura para engenharia de software, com duas dimensões que praticamente ninguém usa para segurança: normas (padrões transversais) e salvaguardas (limites inegociáveis — invariantes, limites de desempenho, regras de segurança). O prompt vira um artefato de primeira classe, versionado junto ao código, com uma regra operacional simples: quando a realidade diverge, corrija o artefato primeiro, depois o código.8
A leitura de segurança dessa regra é direta: hoje, quando um incidente revela que um serviço fazia algo que não deveria, corrigimos o código e escrevemos uma regra de detecção nova. O artefato de intenção — que nunca existiu — segue inexistente. A dívida se acumula em silêncio.
Segunda inversão — a IA generativa sai do caminho crítico da contenção
Esta é a parte contraintuitiva. A promessa corrente é colocar um agente no SOC para triar, decidir e agir. Isso não cabe em cinco segundos, e não é um problema de otimização: é um problema de arquitetura. Chamada a modelo generativo, enriquecimento externo síncrono e raciocínio em cadeia custam segundos e têm variância alta.
A inversão: a IA compila a política; o plano de dados executa a política. Modelos trabalham antes do incidente — traduzindo contratos em regras, treinando linhas de base, gerando testes adversariais, revisando decisões — e depois do incidente, na compreensão. Durante os cinco segundos, quem age é código determinístico, pré-autorizado e testado.
Há um argumento econômico embutido. Relatos do retiro europeu descrevem orçamentos anuais de tokens consumidos em três meses, e variação de até 1.400× no custo de Conteúdo Interno eficiência conforme a arquitetura de acesso a dados corporativos — com o vaivém entre modelo e sistemas internos como fator subestimado.7 Manter o modelo fora do caminho quente é decisão de segurança e de custo.
Terceira inversão — quem avalia o controle não pode ser quem o gerou
O achado mais consistente da engenharia de harness em 2026 é desconfortável: quando pedimos a um agente que avalie o próprio trabalho, ele elogia — mesmo quando a qualidade é obviamente medíocre. Separar o agente que produz do agente que julga é uma alavanca forte, ainda que não elimine a leniência sozinha: calibrar um avaliador externo para ser cético é muito mais tratável do que tornar o gerador crítico de si mesmo. E, uma vez que existe esse retorno externo, o gerador passa a ter algo concreto contra o que iterar.9
Aplicado à segurança: um agente que escreve uma regra de detecção e depois valida a própria regra vai declarar cobertura que não existe. O modelo exige um avaliador adversarial separado, com limiares duros — se um critério fica abaixo do limiar, a entrega falha e volta com o achado específico. Vale registrar também o resultado prático de misturar julgamento determinístico e não determinístico: uma equipe combinou linters e casamento de padrões com um conselho de três modelos julgadores e elevou a aceitação de primeira passagem de cerca de 60% para 80%.
Rogério Athayde – CTO da Keeggo
Esta é a Parte I de uma série de duas sobre o modelo TRAMA. A Parte II apresenta o modelo em si (as cinco camadas do TRAMA), a engenharia que faz a contenção caber em cinco segundos, a integração entre camadas, a governança por autonomia calibrada, o roteiro de implantação em 90 dias e as seis formas do modelo falhar.
Leia a Parte II: 27 segundos contra 241 dias – Parte II